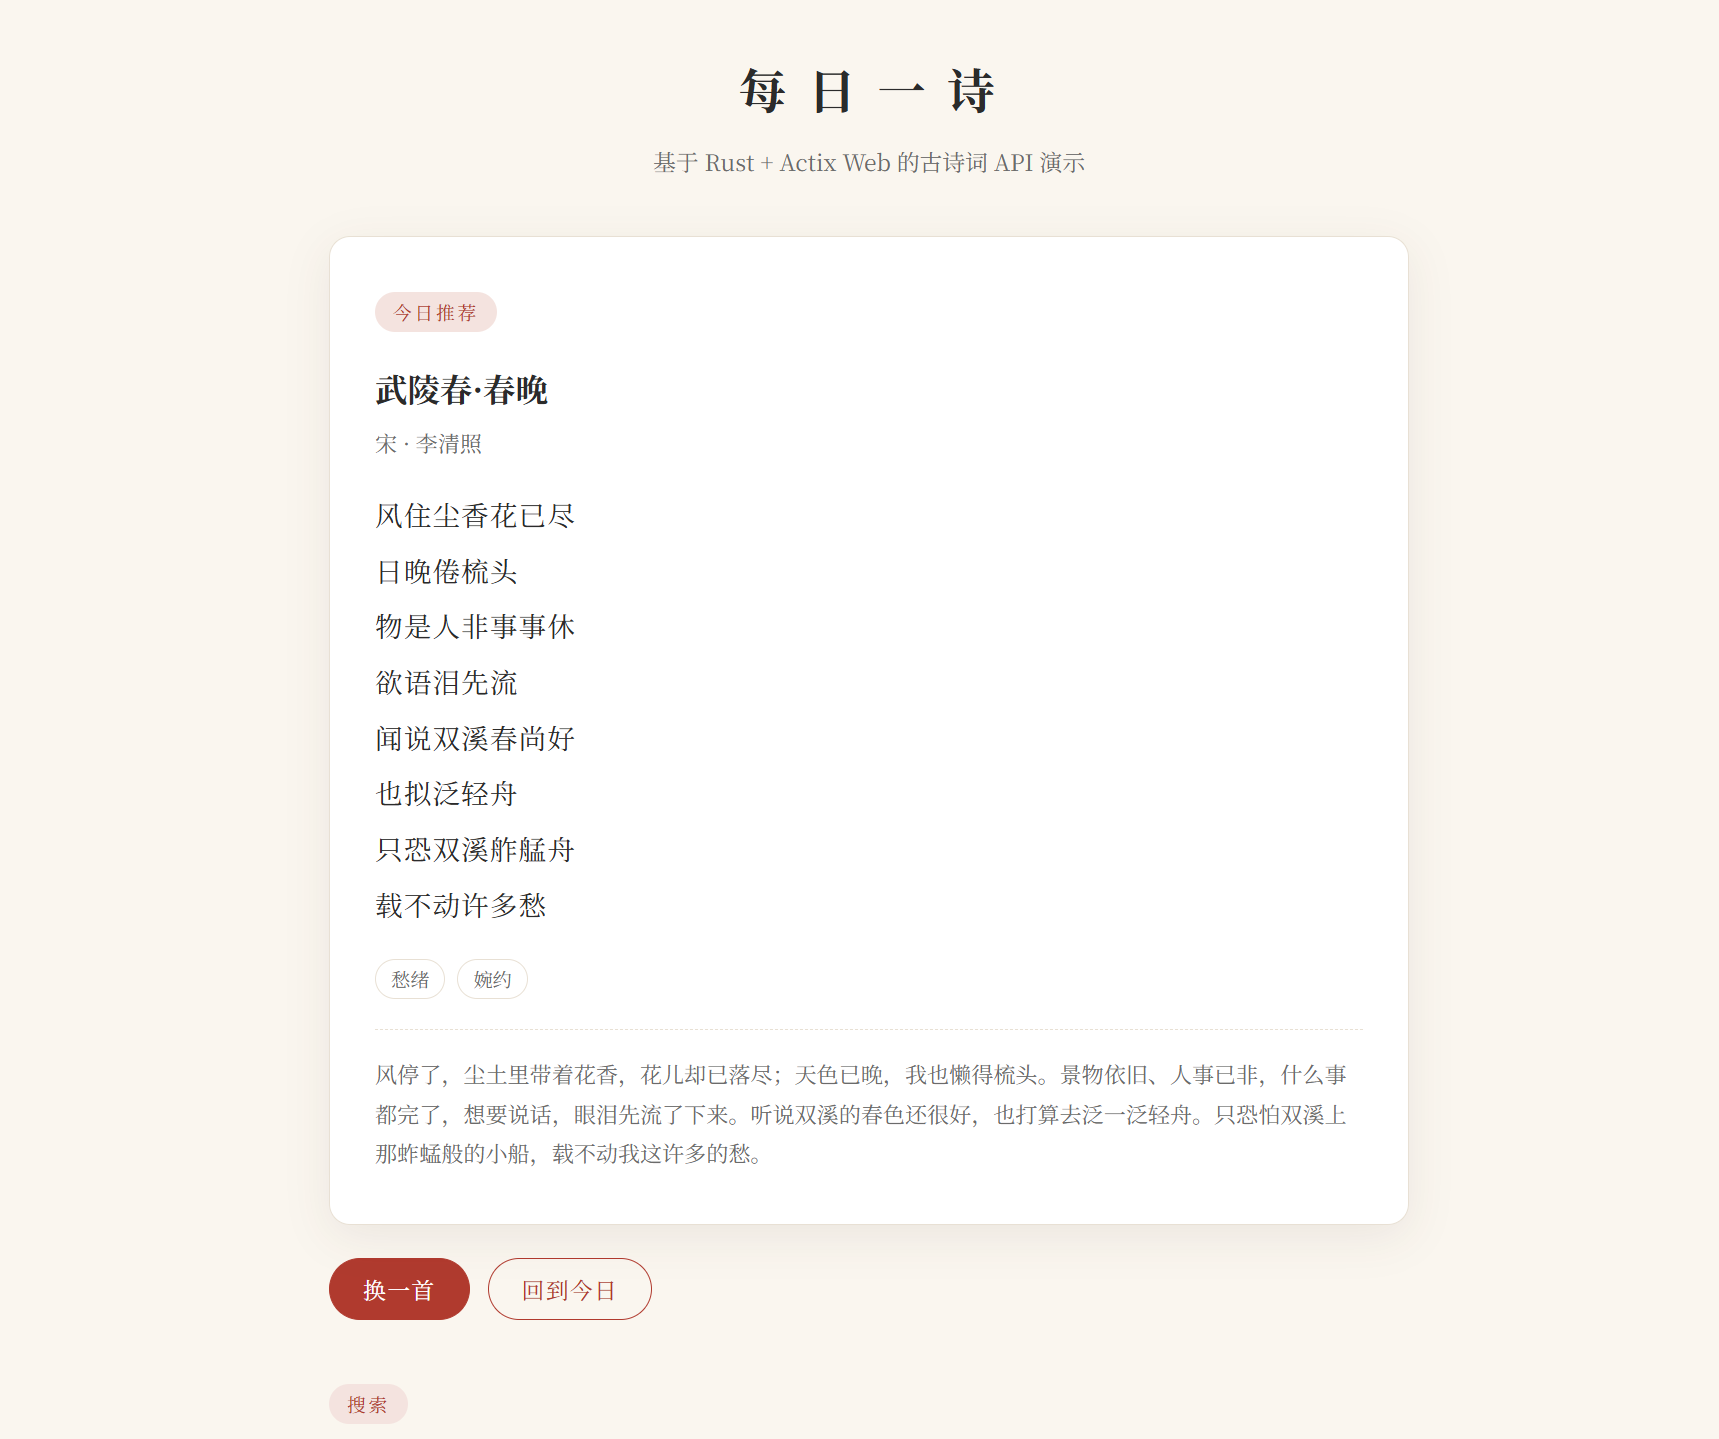
我用 Rust 写了个 13 万首古诗词的 REST API
做一个「每日一诗」的小功能时发现:想在自己的项目里用上古诗词数据,意外地麻烦——数据要自己爬、繁简混杂、中文搜索难搞。于是干脆用 Rust 写了一个完整的古诗词 REST API,最终收录约 13.3 万首唐诗宋词,单二进制部署,开源出来。
这篇文章记录整个构建过程和几个值得一聊的技术点。
为什么做
目标用户是做诗词类产品的开发者:每日推送的小程序、语文教育 App、诗词壁纸、古风网站、聊天机器人语料……
他们面对的痛点很现实:
- 没数据。全唐诗、全宋词散落在各种爬取仓库里,格式不一,还要自己清洗
- 中文搜索难做。
LIKE '%关键词%'在 13 万行上全表扫描,数据量上来后很慢 - 繁简混杂。开源数据集大多是繁体,直接展示给用户不合适
- 部署重。为一个读多写少的语料库上 MySQL/Redis,性价比很低
最终的技术选择:Rust + Actix Web + SQLite,单二进制 + 内嵌数据库,几十 MB 内存就能跑。
架构
分层很常规,但每一层都有明确职责:
1 | 客户端 |
所有接口返回统一结构,错误时 code 为 HTTP 状态码:
1 | { |
接口一共 8 个:列表(分页+筛选+搜索)、随机、每日一诗、详情、朝代分布、作者分布、标签分布,外加 Swagger 文档自动生成。
关键实现
1. 中文全文搜索:SQLite FTS5 trigram
这是整个项目最值得做的一个优化。
最初搜索是五个字段的 LIKE 拼接,13 万行时每次查询都是全表扫描。SQLite 自带 FTS5 全文索引,其中 trigram 分词器按 3 个字符切分,对中文这种没有空格的语言特别合适——不需要任何中文分词库:
1 | CREATE VIRTUAL TABLE poems_fts USING fts5( |
查询时按关键词长度路由:≥3 个字符走索引,更短的子串 trigram 无法命中,自动退回 LIKE:
1 | if keyword.chars().count() >= 3 { |
效果:搜「明月几时有」直接命中苏轼的《水调歌头》,毫秒级返回。
2. 13 万首语料的导入与去重
数据来自开源数据集 chinese-poetry(MIT 协议)。写了一个独立的导入工具 src/bin/import.rs,处理三件事:
繁转简。数据集原文是繁体,用纯 Rust 的 ferrous-opencc(内置 OpenCC 字典,无需外部文件)在导入时统一转换:
1 | let opencc = OpenCC::from_config(BuiltinConfig::T2s)?; |
去重。用「标题|作者|内容」的 FNV-1a 哈希作为 ext_key,加唯一索引 + INSERT OR IGNORE,导入工具可以安全重复执行:
1 | CREATE UNIQUE INDEX IF NOT EXISTS idx_poems_ext_key ON poems (ext_key); |
两层数据结构。这是个刻意的设计:
| 层级 | 数量 | 译文 | 标签 | 用途 |
|---|---|---|---|---|
| 精选集 | 116 首 | 有 | 有 | 每日一诗、网页演示 |
| 全量语料 | 13.3 万首 | 无 | 无 | 搜索、随机、列表 |
数据集本身只有原文没有译文,所以「每日一诗」如果从全库随机,很可能推一首残缺、没译文的诗。它改为只从精选集(ext_key IS NULL)里按日期确定性选取,保证每天推的都是带译文的经典名篇。
3. 限流器:滑动窗口 + 两个容易漏的点
限流用内存里的 HashMap<IpAddr, VecDeque<Instant>> 做滑动窗口。第一版有两个真实问题:
内存泄漏。初版只在某个 IP 再次访问时清理它的旧记录,那些只访问一次就消失的 IP,条目永远留在 HashMap 里,长期运行内存只增不减。修复为按窗口周期全局清扫:
1 | fn sweep_if_due(&self, guard: &mut HashMap<IpAddr, VecDeque<Instant>>, now: Instant) { |
反向代理后误伤所有人。部署在 Nginx 后面时,peer_addr 拿到的永远是 Nginx 的 IP,限流会把所有用户当成一个人。加了 TRUST_PROXY 开关,开启后从 X-Forwarded-For 取最左侧一跳作为真实客户端 IP。
另外 API Key 的比较改成了常量时间比较,避免通过响应耗时差异推测密钥。
4. 其他「为别人调用」准备的细节
- CORS 全开 + gzip 压缩:浏览器前端可以直接
fetch,不用自己搭代理;大响应体自动压缩 - 响应缓存:每日一诗和按 ID 查询走 moka 内存缓存,同一天的请求基本不碰数据库
- OpenAPI 文档:utoipa 自动生成,内置 Swagger UI
踩过的坑
utoipa 的 $ref 解析失败。Swagger 页面报 Could not resolve pointer: /components/schemas/crate.models.ErrorResponse。原因是在 #[utoipa::path] 宏里写了完整路径 body = crate::models::ErrorResponse,utoipa 会按字面量生成引用名,和组件注册的短名字 ErrorResponse 对不上。改成先 use 导入再写短名字即可。
数据集下载。直连 GitHub 超时,jsDelivr CDN 又因为仓库超过 50MB 拒绝了 master 分支;最终唐诗宋诗走 jsDelivr 的历史 tag,宋词走 GitHub 代理。更坑的是新版宋词文件格式变了——标题字段从 title 变成了词牌名 rhythmic,导入工具得兼容两种 schema:
1 | struct RawPoem { |
效果
最终入库数据:
- 唐诗 57,600 首、宋诗 54,779 首、宋词 21,071 首、元曲等 5 首
- 合计约 13.3 万首,全部简体、去重
- 精选集 116 首全部带现代译文和标签(译文是逐首对照原文补写的)
工程状态:10 个单元/集成测试全过,cargo clippy -D warnings 零警告,CI 跑 fmt + clippy + test。
部署形态就是一个二进制加一个 SQLite 文件:cargo build --release 后上传,HOST=0.0.0.0 ./poem_api 即可运行,前面挂个 Nginx/Caddy 做 HTTPS。
最后
这个项目的初衷很朴素:把「找诗词数据」这件重复的事一次性解决干净。SQLite 的 FTS5 让中文搜索不需要引入任何重型依赖,Rust 让最终产物省心到「一个二进制丢到服务器上就能跑」。
项目已开源(MIT),代码里有完整的中文注释,也适合作为 Rust Web 分层、中间件、SQLx 的学习样例。
更新时间: 2026-09-06
作者: Jay