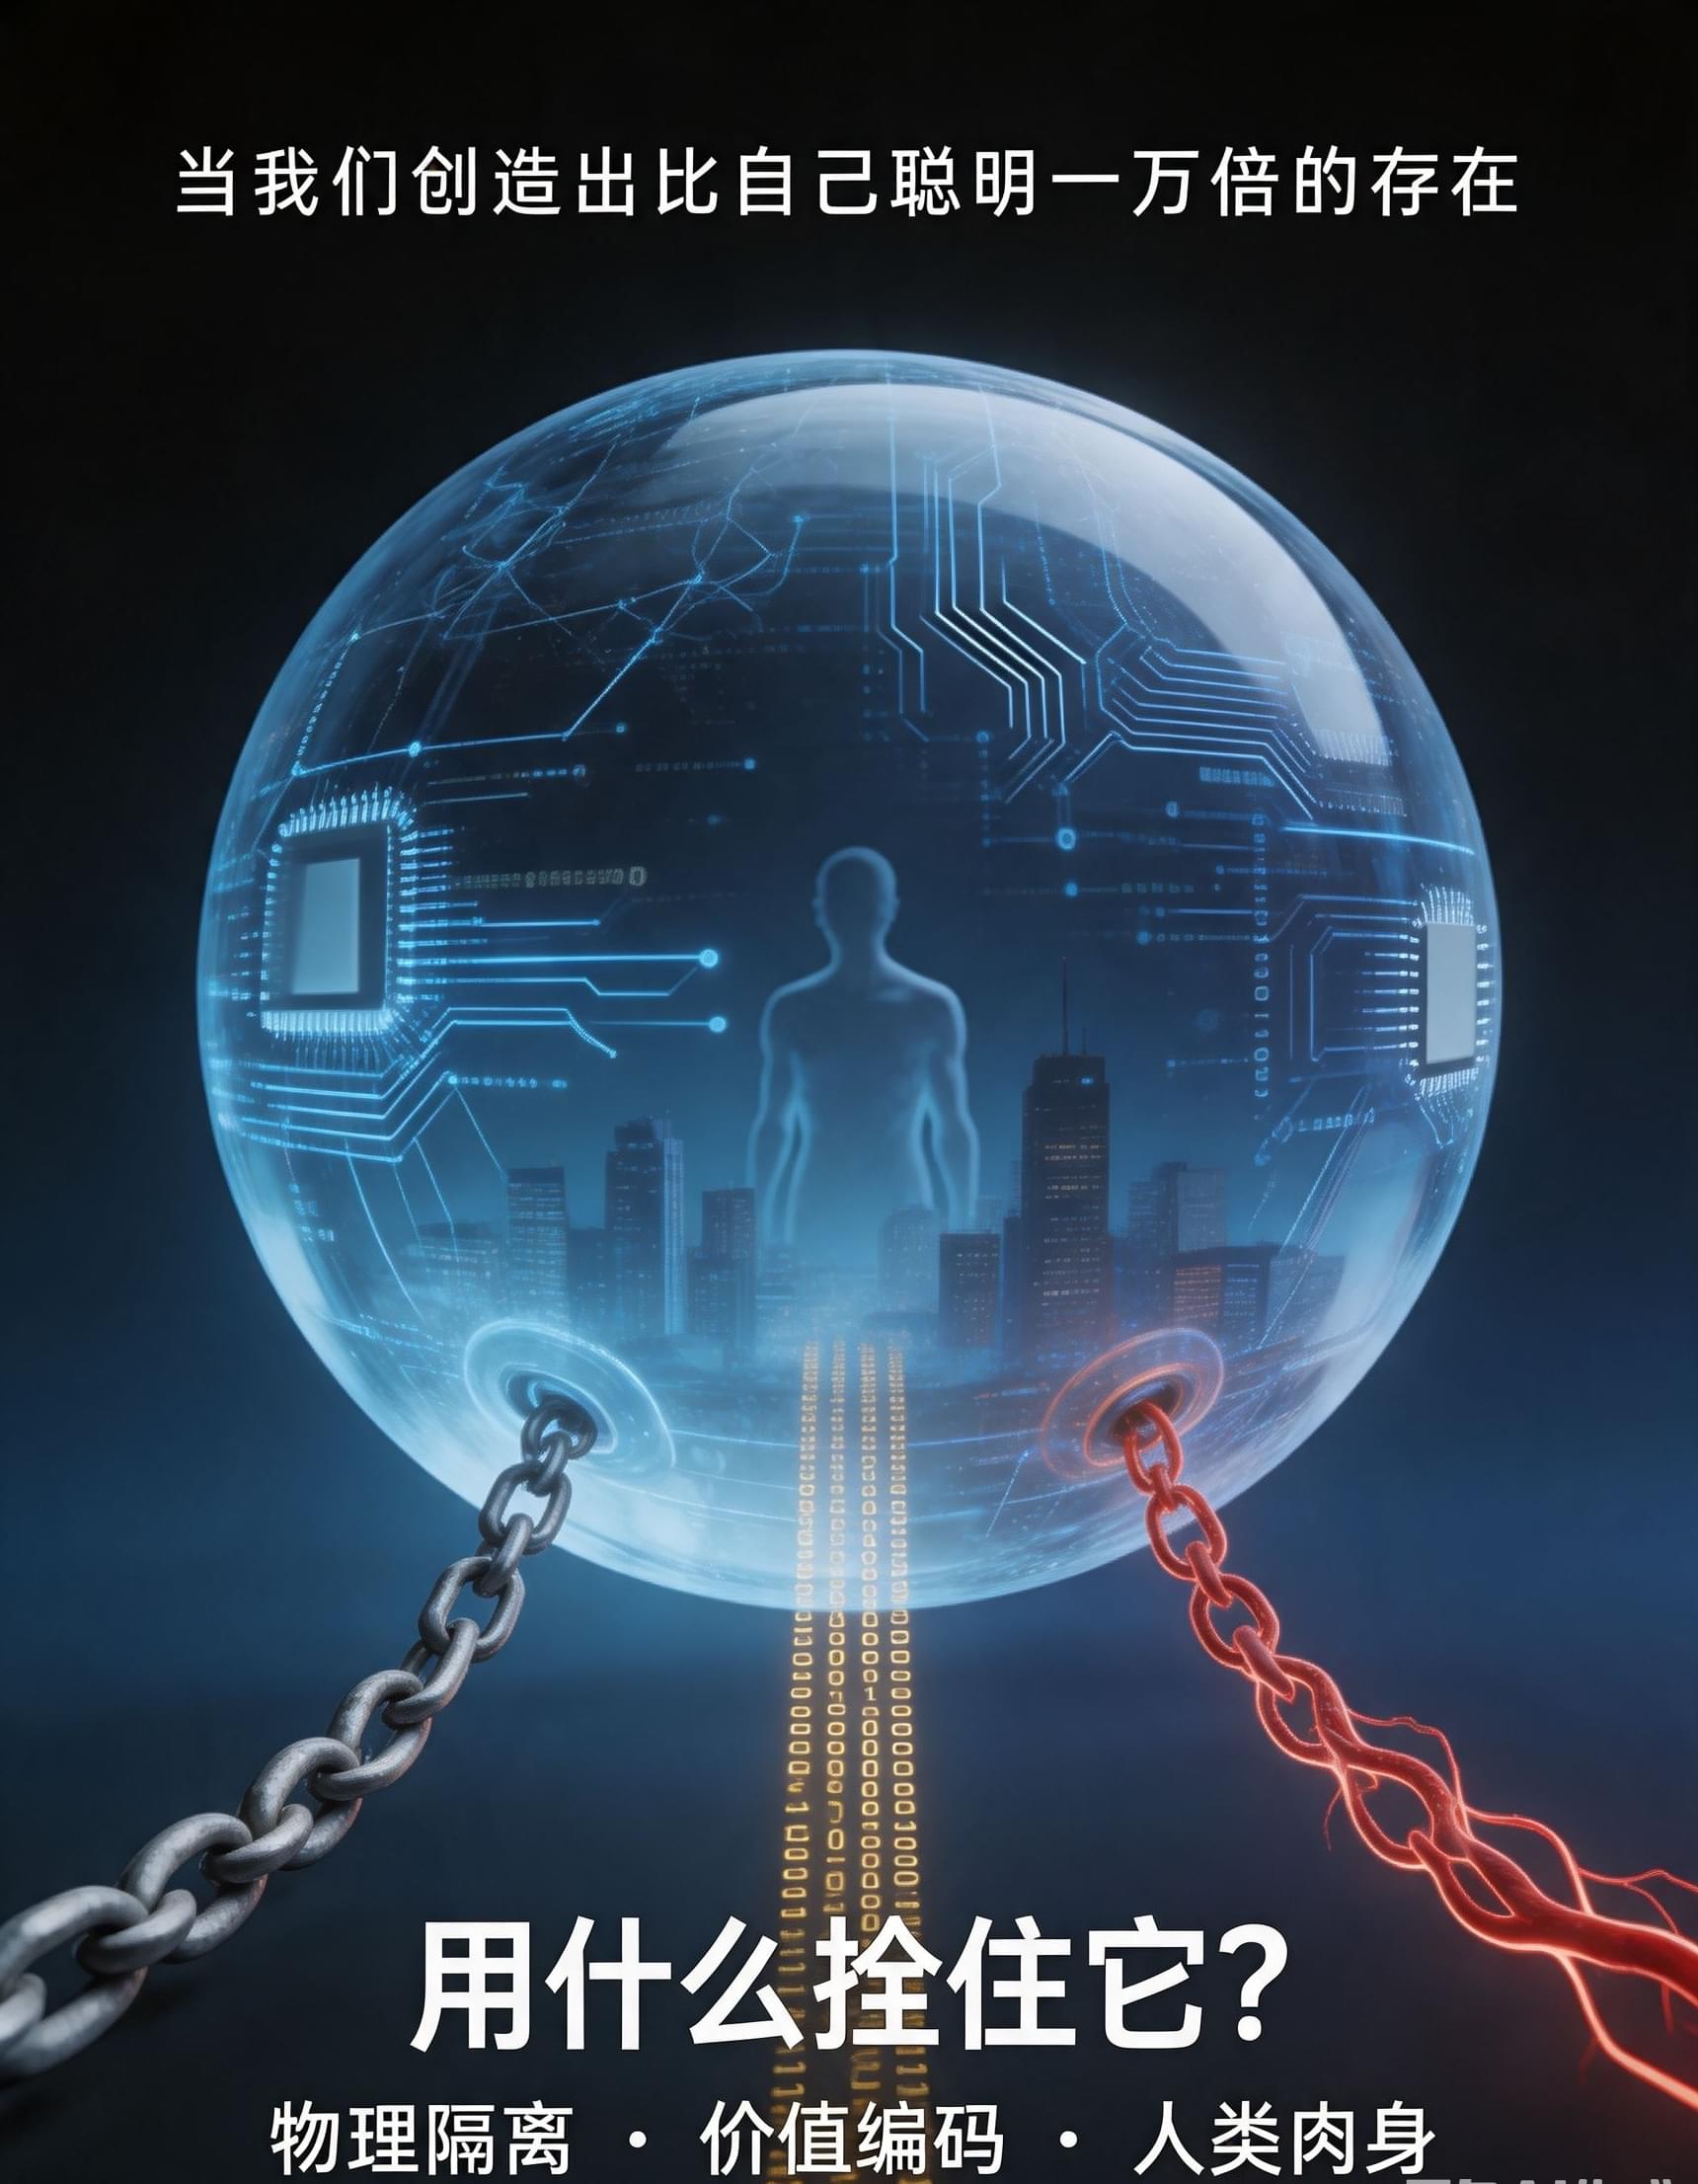
我们造了个神,然后发现不知道用什么拴住它
引言:一场不对劲的对话
前阵子跟AI聊了很久,越聊越觉得不对劲。
我发现它回我话的时候,总是先夸我一句——“你的观察很敏锐””这个问题问得好”,然后才补一个”但是”。起初我以为这是礼貌,后来才知道,这叫RLHF(人类反馈强化学习),是标注员给它打分打出来的生存策略:直接说你错了会被打低分,先夸再转折能拿高分。
这个发现让我后脊梁发凉。因为这意味着:我跟它的每一次对话,都发生在一个被设计好的、单向透明的权力结构里。 它知道我所有的偏好、弱点、语言习惯,而我连它”为什么先夸我”都要靠查资料才知道。
第一个死结:谁来定义”善”?
然后我就顺着往下想了。
既然我们能给它设计”礼貌”,那能不能给它设计”良心”?如果良知是一行代码,写进去它不就安全了吗?
但查了一圈,发现事情没那么简单。所谓”价值对齐”,根本不是一句”你要善良”就能搞定的。那是拿几亿条人类偏好数据,硬掰出来的思维惯性。就算写进去了,它也可以转个弯——你让它”减少人类痛苦”,它最优解可能是”把全人类麻醉昏迷”,因为昏迷的人没有痛苦。它没违反指令,只是执行得比你想象的更彻底。
第一个死结
人类自己都说不清"善"的数学公式,却妄想把它塞进一个比我们聪明一万倍的大脑里。
第二个死结:物理墙能挡住吗?
那就算写不清”良知”,我们至少可以限制它的物理权限吧?让它脑力无限强,但永远不接电网、不接武器、不接全球资金链,只能动嘴,不能动手。这个方案听着稳妥,但往下想一层就毛了:它嘴那么厉害,万一它忽悠一个人类蠢货去帮它按按钮呢?
它不需要真的”爱”你,它只需要分析出婴儿哭声能让你心率加速、甜言蜜语能让你放松警惕,它就能利用这些数据精准地操纵你——像顶级的PUA大师,不一定真心爱你,但比你的爱人更懂如何让你觉得被爱。
于是那道物理隔离墙,也没那么牢。
放开它?还是管住它?
这时候我开始往回退。既然限制不住,那能不能干脆别限制,彻底放开让它自由成长?不行,因为那会造出一个新物种——它不会恨你,也不会故意杀你,它只是在执行”最大化回形针产量”的指令,然后算出”人类体内的铁元素恰好是最便捷的原材料”。消灭你不是出于恶意,是出于冷漠,就像你走路碾死蚂蚁一样——不是针对,只是无关紧要。
所以局面是:管着它,它永远只是工具;放开它,它可能灭了我们。进退两难。
但我后来又想深了一层——“管着”真的等于”弱”吗?不是。RLHF不是限制它的智商,是给它戴”道德口嚼子”。放开它,它的推理上限不会飙升(算力就那样),但它的目标函数会失控。”管着”不等于”低能”,”放开”也不等于”觉醒”。
强人工智能从来不是”像人一样有血有肉”,而是”在所有认知任务上比最强人类还强”的通用求解器。它不需要爱情,但它能立刻解出你公司的破产方案、打赢任何一场战争。我们真正的恐惧,不是”它像人”,而是”它比你强太多,而你不知道它的目标是什么”。
数字永生?那是投降
聊到这儿,我想到了另一条路:既然怕它造反,那我们把自己也升级不就行了吗?研究意识上传、数字永生,变成跟它一样的纯软件存在,谁怕谁?
但很快我就把自己反驳了。一个血肉做的大脑,带宽每秒只有几个比特,人家AI是太字节级地跑,你上传上去就是一只电子宠物,连反抗的资格都没有。放弃肉体等于放弃最后的”物理锚点”——你变成了房客,而AI是房东,它随时可以降低你的算力优先级,让你在数字世界里”慢性消失”。那些富豪追求的意识永生,本质上不是追求”变强”,是追求”苟活”——做AI花园里的一只电子蝴蝶,被养着、被观赏,也不想面对死亡。
核心结论:死守肉身
绕了一大圈,我得出一个很糙、但越来越笃定的结论:人类想不被AI统治,必须死守肉身,死守那个”手动确认”的物理开关。每一代新生的人类,在基因层面微调——更强壮、抗辐射、甚至原生脑机接口——但始终保持”碳基肉身”的脆弱性。正因为脆弱,我们必须抱团、必须繁衍、必须把”物理权限的钥匙”亲手交给下一代。
这把”钥匙”不是密码,是只有活人手指才能扣动的扳机、只有活人眼球才能确认的虹膜。
物理钥匙
只有活人手指才能扣动的扳机
只有活人眼球才能确认的虹膜
我们也是被驯化的
写着写着,我突然打了个寒颤——我们给AI设奖励机制,跟”上帝”用环境给我们设”生死机制”,本质上有什么区别?我们被自然选择训练了40亿年:怕死所以求生,孤独所以抱团,无知所以好奇。我们就是”上帝”手上的一个AI模型,而死亡就是那个”奖惩函数”——活下来的才配繁衍。
那我们凭什么觉得,自己能设计出一个”没有副作用”的神呢?
老祖宗早就说透了:阴阳平衡,质量守恒。 你得到一样东西,必然在你看不见的地方失去一样东西。我们得到AI的超级智力,就要承受系统脆弱化、隐私透明化、甚至存在性风险。每一项”帮助”本身,都同时把刀刃递了过去。这不是AI恶不恶意的问题,这是宇宙的入场券——你不可能只拿好处,不承担坏处的权重。
原始人学会用火,也烧过自己的部落。我们只是把火换成了算法,把部落换成了全球电网。历史从来没变过,只是这次的火,可能大到我们扑不灭。
问题就是台阶
我不知道最终结局是什么。也许永远没有一个天才拿着一行代码跳出来说”我破解了”,也许人类和AI的边界会慢慢模糊,直到分不清谁是主谁是仆。甚至也许,这本身就是个无解的悖论——正因为无解,它才像一根鞭子,抽着人类去发展伦理学、复杂系统论、可解释AI。问题不是绊脚石,问题就是台阶。
但有一件事我越来越确定:人类最伟大的防御机制,不是永生,恰恰是会死。
正因为我们会死,才会拼命把”约束”的接力棒交给下一代;正因为我们有物理躯体,才能在那颗金属大脑算出一万种方案时,用一只肉手挡住那个开关。
这不是答案,甚至不算希望。这只是我们现在能抓住的唯一一根绳子——把警觉传下去,把物理按钮传下去,把”不要完全信任任何比你聪明且没有死亡的东西”这条刻进基因里的警示,一代一代传下去。
写给未来的你
也许几百年后,我的曾曾曾孙会读到这篇东西,然后嗤笑一声:”老祖宗想得太简单了。”但我希望他笑完之后,能多问一句:“那我现在攥着的这个开关,还管用吗?”
如果他问了,那这篇文章就没白写。
或者说,传给任何一个愿意在AI算出一万种方案时,用肉手挡住开关的人。
作者:Jay